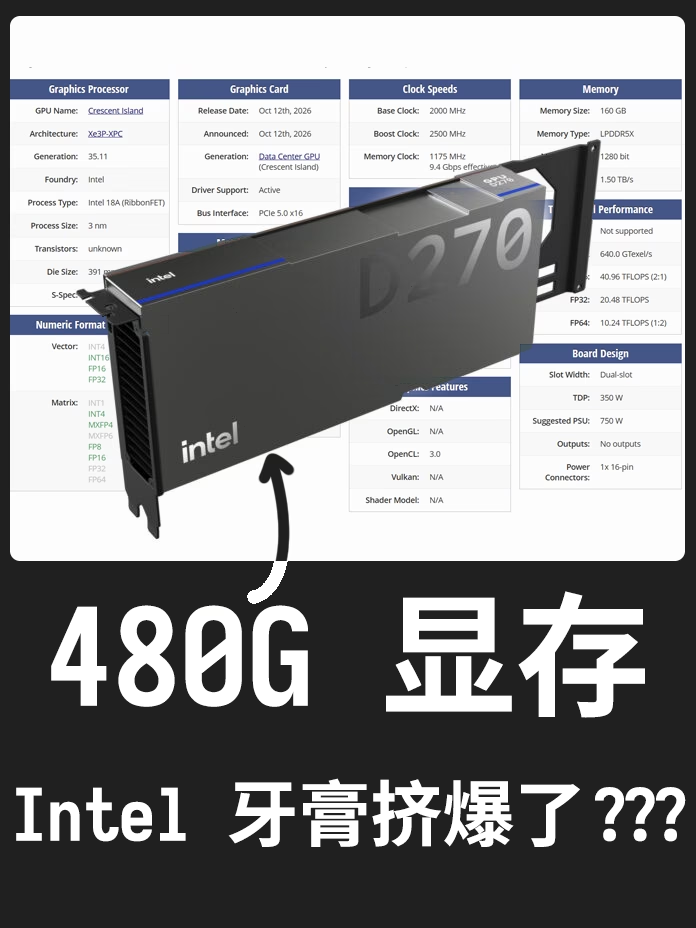
intel 终于开窍了, 在今年的OCP峰会上展示了Crescent Island系列新显卡的最新信息: intel D270.
我研究了一下卡的参数, 给大家分析一波这个卡运行本地模型会不会直接核弹爆炸:
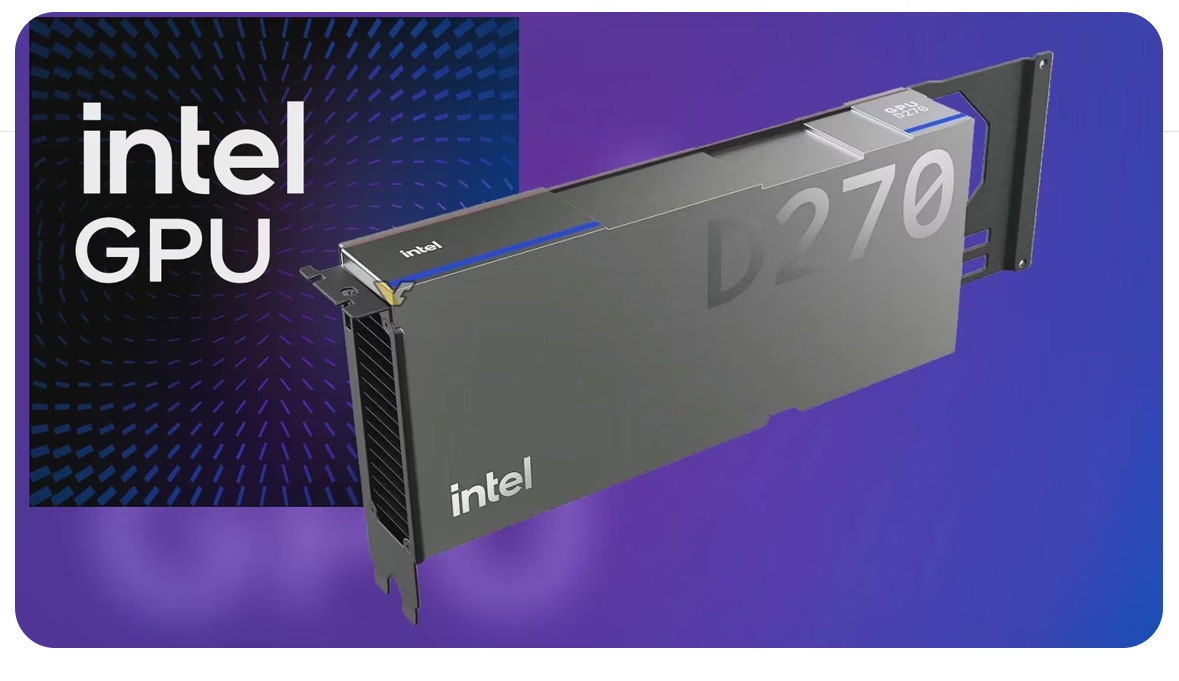
首先这个卡是原生支持OCP微缩放格式标准的(毕竟intel自己参与起草的标准), 所以完全支持 OCP MXFP4(E2M1)/ MXFP8, 也就是说4bit/8bit量化根本不用软模拟, 完全就是硬件XMX加速运算. 当然 NVFP4是不行的, 这个只有N卡能用(没事可以跑MXFP4).
官方给到的它的单卡 FP8 浮点性能是 1.3 PFLOPS, 据此可以推算 FP4 能达到约 2.6 PFLOPS
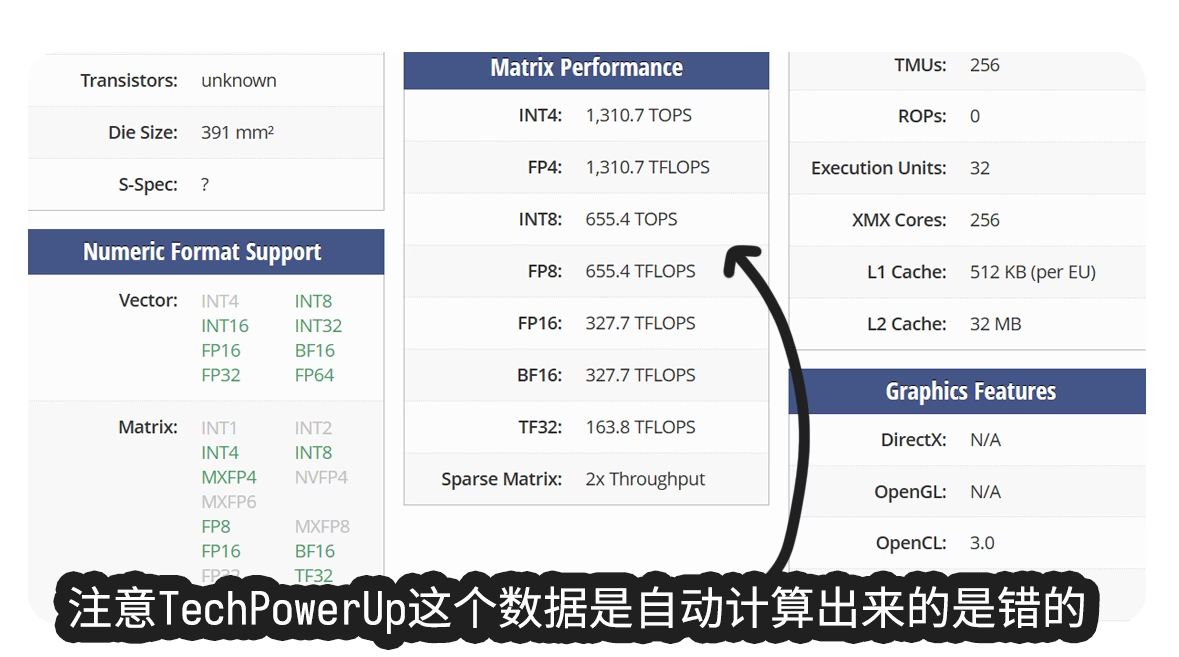
这样的话如果运行 Qwen3.8-27B-8bit, Prefill 速度理论上能达到24,074tps, 4bit则可以翻倍, 达到48,148tps,
如果换成 DeepSeek-v4.1-flash-4bit, 因为 deepseek 的神奇魔法, Prefill 只需要激活 8B, 那么理论 Prefill 甚至能干到 162,500tps (实际估计应该在7万左右).
这么看来, 这张卡的浮点性能是相当够的, 即使每次都塞进去小说, 都能做到秒吐字.
重点来了, 那么这个张卡说是单卡最大 480G 显存, 这不是把老黄/水果按在地上打吗?
且慢, 我看了一下卡的零售版本其实最大是160G显存, 480G是专门给ODM厂商(HP, DELL等)专供的. 所以单独买的话160G就是极限了(捡垃圾另算). 但好消息是, 160G 和 480G 的显存带宽一样, 都是 LPDDR5x, 能干到 1.5TB/s. 这个GPU相当猛, 给了 1280-bit位宽的显存控制器, PCB 正反两面总共贴了 20 颗 LPDDR5x 颗粒(160G 版对应单颗 8GB / 64Gb, 480G 版对应高密度的单颗 24GB / 192Gb)
所以单卡运行Qwen3.8-27B-4bit , Decode速度可以达到111tps, 而运行DeepSeek-v4.1-flash-4bit 能达到187.5tps左右 (均为理论值, 且单卡160G装不下ds, 还是要单卡480G, 或双卡160G).
而且驱动啥的完全不用担心, vLLM, SGLang, PyTorch 也都做了适配.
不过这个卡短板也很明显, 它完全没有类似 NVLink 的卡间高速互联桥, 跨卡只能走 PCIe 5.0, 单向带宽最高 64GB/s. 所以这卡就是纯粹瞄准高密度大模型推理市场的, 拿来做跨机大规模预训练是不行了, 但如果拿它单卡搞 70B 模型的 LoRA / QLoRA 微调, 超大显存会爽到飞起.
就看这卡最后给什么定价了, 要是价格合适, 真能把现在的推理加速卡市场搅得天翻地覆!